

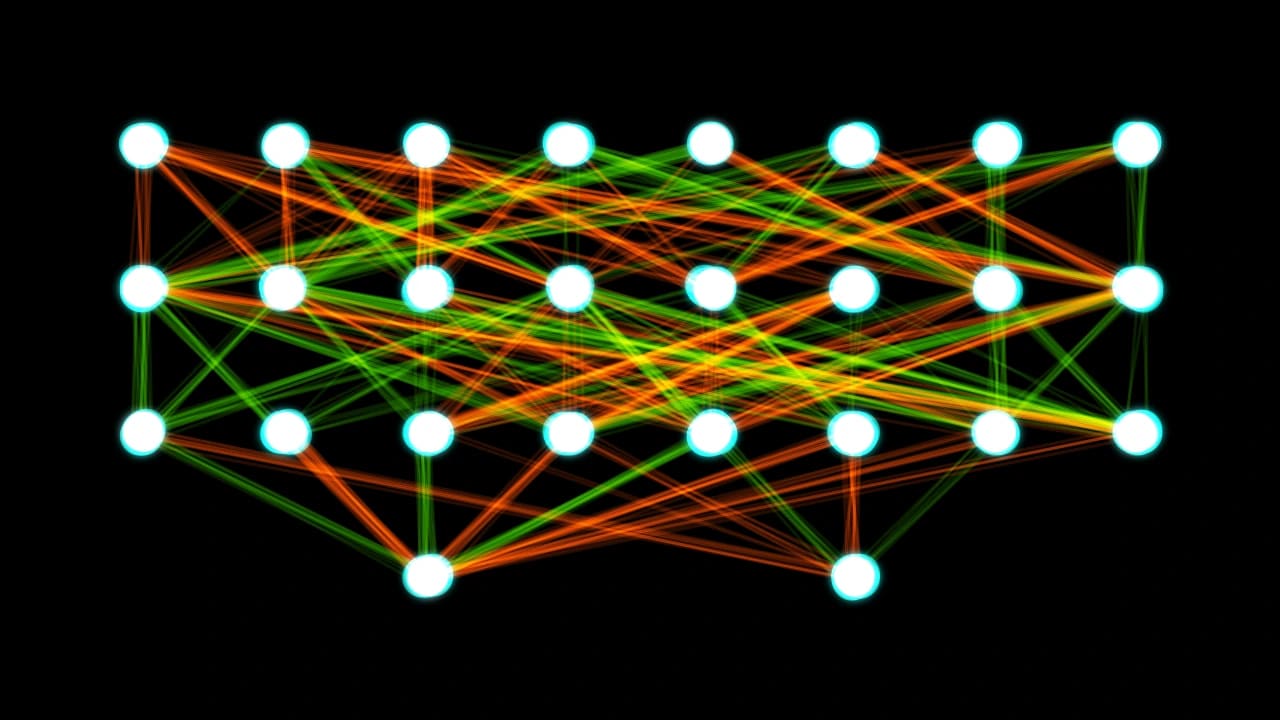
人工智能正處於一個有趣的時刻。長久以來,AI 的進展一直遵循一條簡單的規則:讓模型變得更大。更多參數、更多數據、更多算力。這種做法確實有效,但也帶來了嚴重問題。訓練大型模型成本高昂、耗時,而且消耗大量能源。
最近,Nvidia 提出了一個不同的概念,稱為 Mixture of Experts,簡稱 MOE。模型不再為每項任務啟動整個神經網絡,而是學會選擇系統中真正需要的部分。每個部分都像是某個特定領域的專家。面對任何問題,模型只會動用最相關的專家。
這讓系統更高效,也更靈活,與人們的工作方式相似。你不會遇到任何問題都向所有認識的人求助,而是會找最適合處理當下情況的人。透過 MOE,AI 系統可以變得更聰明,而不必變得過於龐大笨重。
許多研究人員相信,這個方向對實現通用人工智能(AGI)這個長遠目標十分重要。一個能處理各種問題的系統,不能單靠規模龐大。它需要具備決策能力,知道該在甚麼時候運用哪些能力。
這個想法並不限於研究論文。
事實上,我們在 Dvina 一直採用類似的方法。從一開始,我們就假設沒有任何單一語言模型或工具能夠樣樣精通。因此,我們沒有依賴單一模型,而是在多個模型、工具和數據來源之上建立了一個協調層。
這個協調層負責決策。當用戶提出問題時,它會決定應該使用哪個模型或資源。有時只用一個,有時則結合多個,再整合結果。目標不是展示系統的複雜性,而是將複雜性藏在簡單的體驗背後。
結果是一個讓人感覺能靈活應變的系統。你提出問題,系統便會找出最有效率的回答方式。這與 MOE 在模型層面提出的理念十分接近,只是應用在系統層面。
AGI 尚未到來。但 MOE 這類想法顯示,未來的發展不只關乎規模,也關乎結構、協調,以及更明智地運用資源。
If you are curious what this kind of approach feels like in practice, you can try Dvina for free at https://dvina.ai. It is not AGI, but it gives a small glimpse into how future AI systems may think and operate.



