

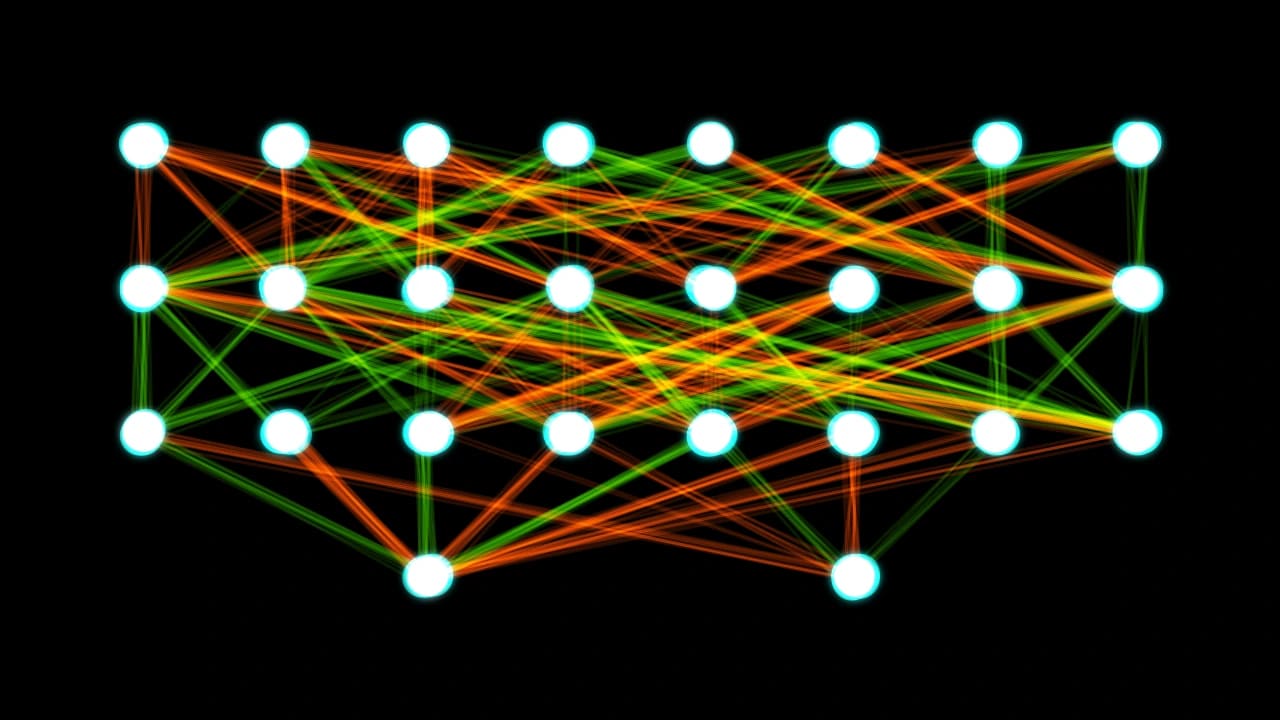
Kawili-wili ang yugtong ito para sa artificial intelligence. Sa mahabang panahon, sinunod ng pag-unlad ng AI ang isang simpleng tuntunin: palakihin ang mga modelo. Mas maraming parameter, mas maraming data, mas malaking kapasidad sa pag-compute. Epektibo ito, pero nagdulot din ng malulubhang problema. Magastos at mabagal ang pagsasanay ng malalaking modelo, at napakalaki ng enerhiyang kinokonsumo nito.
Kamakailan, ipinakilala ng Nvidia ang ibang ideya na tinatawag na Mixture of Experts, o MOE. Sa halip na i-activate ang buong neural network para sa bawat gawain, natututo ang modelo na pumili kung aling mga bahagi ng sistema ang talagang kailangan. Ang bawat bahagi ay nagsisilbing eksperto sa isang partikular na larangan. Para sa anumang tanong, ang mga ekspertong may pinakamalaking kaugnayan dito lamang ang ginagamit.
Dahil dito, nagiging mas episyente at mas madaling umangkop ang sistema. Katulad ito ng paraan ng pagtatrabaho ng mga tao. Hindi ka humihingi ng tulong sa lahat ng kakilala mo para sa bawat problema. Lumalapit ka sa mga taong pinakaangkop sa sitwasyong iyon. Sa MOE, maaaring maging mas matalino ang mga AI system nang hindi nagiging mabigat nang higit sa kailangan.
Maraming mananaliksik ang naniniwalang mahalaga ang direksiyong ito para sa pangmatagalang layuning makamit ang Artificial General Intelligence, o AGI. Hindi sapat ang laki lamang para sa isang sistemang kayang lumutas ng maraming iba’t ibang uri ng problema. Kailangan nitong makapagpasya. Kailangan nitong malaman kung aling mga kakayahan ang gagamitin at kung kailan.
Hindi limitado sa mga research paper ang ideyang ito.
Sa katunayan, gumagamit na kami ng kahalintulad na paraan sa Dvina. Mula pa sa simula, ipinagpalagay namin na walang iisang language model o tool na magiging mahusay sa lahat ng bagay. Sa halip na umasa sa iisang modelo, bumuo kami ng orchestrator layer na nasa ibabaw ng maraming modelo, tool, at pinagmumulan ng data.
Nagsisilbing patong para sa pagpapasya ang orchestrator na ito. Kapag nagtatanong ang isang user, nagpapasya ito kung aling modelo o mapagkukunan ang dapat gamitin. Minsan, isa lang ang ginagamit nito. Minsan naman, gumagamit ito ng ilan at pinagsasama ang mga resulta. Ang layunin ay hindi ipakita ang pagiging komplikado ng sistema, kundi itago ito sa likod ng isang simpleng karanasan.
Ang resulta ay isang sistemang tila marunong umangkop. Nagtatanong ka, at inaalam ng sistema kung paano sasagot sa pinakaepisyenteng paraan. Napakalapit nito sa diwa ng iminumungkahi ng MOE sa antas ng modelo, pero inilalapat sa antas ng sistema.
Hindi pa dumarating ang AGI. Pero ipinapakita ng mga ideyang tulad ng MOE na ang landas pasulong ay hindi lang tungkol sa laki. Tungkol ito sa istruktura, koordinasyon, at mas matalinong paggamit ng mga mapagkukunan.
Kung gusto mong maranasan ang ganitong paraan sa aktuwal na paggamit, maaari mong subukan ang Dvina nang libre sa https://dvina.ai. Hindi ito AGI, pero nagbibigay ito ng munting sulyap sa kung paano maaaring mag-isip at gumana ang mga AI system sa hinaharap.



